Обнаружение аномалий в видео больших данных с помощью улучшенного автоэнкодера
Jul 12, 2023
1. Введение
Как высокоуровневая задача компьютерного зрения, обнаружение аномалий видео относится к автоматическому обнаружению аномальных событий в заданной видеопоследовательности, которое может эффективно различать аномальные и нормальные действия и аномальные категории в видео. В последние несколько лет исследователи провели множество исследований, связанных с обнаружением аномалий [1–9]. По сравнению с нормальными событиями события, которые происходят редко или имеют низкую вероятность возникновения, обычно считаются аномальными. Однако на практике сложно создать эффективную модель обнаружения аномалий из-за неизвестных типов событий и нечетких определений аномалий. Большинство существующих методов обнаружения аномалий разработаны на основе предположения, что любой паттерн, отличный от изученного нормального паттерна, рассматривается как аномалия. На основании таких допущений одна и та же деятельность в разных сценариях может быть представлена как нормальные или нештатные события. Например, сцена драки, где два человека дерутся на улице, может считаться ненормальной, тогда как два человека боксируют нормально. Кроме того, в многомерных видеоданных присутствует большое количество избыточной визуальной информации, что увеличивает сложность представления событий в видеоряде.

Цистанхе китайская трава
Согласно предыдущим работам, методы обнаружения аномалий в целом можно разделить на два типа. Некоторые методы обнаружения аномалий разрабатываются с помощью ошибок реконструкции, которые фокусируются на моделировании нормальных паттернов в видеопоследовательностях [3–5, 7, 8, 10, 11]. (Эти методы изучают модель представления признаков нормального паттерна на этапе обучения и используют различия между аномальными и нормальными образцами для определения окончательной аномальной оценки тестовых данных на этапе тестирования, таких как ошибки реконструкции или определенные пороги [7]. –14].Хотя методы обнаружения аномалий, основанные на реконструкции, хорошо восстанавливают нормальные паттерны в видеопоследовательностях, основная проблема этих методов заключается в том, что они в значительной степени зависят от обучающих данных.Другой тип метода рассматривает обнаружение аномалий как проблему классификации [ 15, 16]. Для этих методов оценка аномалии видеопоследовательности прогнозируется с помощью обученного классификатора для извлечения таких признаков, как гистограмма оптического аналога (HOF) или динамическая текстура (DT) (производительность этих методов оценивается как сильно зависит от обучающих выборок.Чтобы получить удовлетворительную производительность, для таких методов обнаружения аномалий необходимо извлечение эффективных и дискриминационных признаков [17-20]. Однако два типа методов обычно достаточно просто моделируют отношения между событиями [7, 10, 21–23]. Например, рассматривается только линейная связь, чего недостаточно для сложных, сильно нелинейных связей во многих реальных случаях.
Цистанхе, живущая в пустыне
В последние годы методы, основанные на глубоком обучении, были применены к области обнаружения видео и достигли больших успехов [24–26]. Например, автоэнкодеры (AE) используют ошибки реконструкции для обнаружения аномалий, и на этой основе был усовершенствован ряд методов. Кроме того, для решения проблемы обнаружения аномалий также применялись генеративно-состязательные сети (GAN) и долговременная кратковременная память (LSTM). Тем не менее, AE может иметь сильную способность к обобщению, что приводит к способности реконструировать аномальные события. В [14] исследователи указали, что, поскольку аномальных обучающих выборок нет, реконструкция аномальных выборок должна быть непредсказуемой, что может привести к большим ошибкам реконструкции аномальных выборок. Если некоторые аномалии имеют общий шаблон композиции с обычными обучающими данными или декодер «слишком силен» и не может хорошо декодировать некоторые коды аномалий, то АЭ может хорошо реконструировать аномалию. Чтобы преодолеть недостатки AE, в этой статье используется модуль памяти для улучшения глубокой AE и разрабатывается метод AE с расширенной памятью (Memory AE). Когда вводится новый тестовый образец, Memory AE не будет напрямую кодировать его и вводить в декодер, а использовать его как запрос для извлечения соответствующего содержимого в модуле памяти. (en, содержимое агрегируется и передается в декодер. (Этот процесс реализуется с помощью адресации внимания. Кроме того, в этой статье используются дифференцируемые операторы сжатия, чтобы вызвать разреженность весов адресации памяти, что может стимулировать содержимое памяти обращаться к запросам в функции) пространство.На этапе обучения кодировщик и декодер одновременно обновляют модуль памяти, чтобы получить более низкую среднюю ошибку реконструкции.На этапе тестирования изученное содержимое памяти фиксируется, и будет использоваться небольшое количество обычных элементов памяти для реконструкции.Если они выбраны в качестве окрестности входного кода, ошибка реконструкции будет очень очевидной.Эксперименты с несколькими общедоступными эталонными наборами данных показывают, что производительность обнаружения Memory AE достигла современного уровня техники.

Основные химические составляющие цистанхе пустынной
2. Принцип алгоритма
На рисунке 1 показана общая сетевая структура Memory AE, которая разделена на три подструктуры: кодировщик (используется для кодирования ввода и генерации запросов), декодер (используется для реконструкции) и модуль памяти (с памятью и соответствующими операциями адресации). Как показано на рисунке 1, при наличии тестируемого события кодировщик сначала получает его закодированное значение. Используя закодированное значение в качестве запроса, модуль памяти извлекает наиболее релевантное содержимое в модуле памяти с помощью оператора адресации на основе внимания, а затем передает его декодеру для восстановления. Во время обучения кодировщик и декодер оптимизируют параметры, чтобы минимизировать ошибку реконструкции, и в то же время обновляют модуль памяти для записи элементов-прототипов закодированных нормальных данных. Учитывая тестовый образец, модель использует только ограниченные нормальные образцы, записанные в модуле памяти, для выполнения реконструкции. Таким образом, реконструкция имеет тенденцию быть близкой к нормальному образцу. Следовательно, ошибка восстановления нормальной выборки мала, а аномальная ошибка велика.
Рисунок 1: (e блок-схема предлагаемой памяти AE.

2.1. Кодеры и декодеры. (Кодер и декодер являются двумя частями AE. (Первый сопоставляет входные данные с пространством признаков, чтобы получить его закодированное значение, а второй реконструирует закодированное значение во входные данные. (e AE состоит из кодер fw1 (·) и декодер gw2 (·), которые могут быть выражены как

где x и x′ — вход АЭ и реконструированный вход соответственно, z — результаты кодирования x, а W1 и W2 — параметры кодера и декодера, которые можно получить, минимизируя ошибку восстановления между х и х':

Путем восстановления ошибки нормальной выборки [19, 20] для определения того, является ли она аномальной, АЭ успешно используется для решения задачи обнаружения аномалий. Однако реконструкция аномальных образцов должна быть непредсказуемой, что может привести к большим ошибкам реконструкции аномальных образцов. Чтобы решить эту проблему, в разделе 2.2 к AE вводится модуль памяти, и предлагается Memory AE.
2.2. Модуль памяти. (Предлагаемый способ включает в себя модуль памяти для записи режима кодирования прототипа и операцию адресации для доступа к модулю памяти.
2.2.1. Представление на основе внимания. (Модуль внимания представляет собой матрицу M ∈ RN×C, содержащую N векторов реального времени. Для простоты предположим, что C является размерностью z; тогда пусть Ζ ≤ RC. Для вектора-строки mi, ∀i ∈ [ N], где [N] — целое число от 1 до N. Каждый представляет mi элемент памяти, при заданном наборе запросов z ∈ RC сеть памяти получает ?z и отвечает вектором мягких адресов w ∈ R1×N как следует:

где w — вектор-строка, а сумма всех элементов равна 1, что представляет wi, элемент w из i. (весовой вектор e может быть получен путем вычисления z. Как показано в уравнении (4), вес адреса должен быть близок w к модулю памяти. (e смешанный параметр определяется как N, максимальная емкость модуля памяти. Несмотря на то, что это N, найти лучшее для разных наборов данных непросто, к счастью, Memory AE не чувствительна к настройке N. Достаточно большое N можно хорошо применить к каждому набору данных.
2.2.2. Внимание к адресации памяти. В Memory AE модуль памяти предназначен для подробной записи исходного нормального режима M фазы обучения. (Модуль памяти определяется как адресуемая по содержимому память, z⌢ , и его схема адресации вычисляет w, вес внимания, на основе сходства между запросом и элементом памяти. Как показано на рисунке 1, каждый вес можно вычислить с помощью операция softmax с:

где d(·, ·) представляет собой меру подобия. (в статье это определяется как косинусное подобие:

Как и в уравнениях (4)–(6), модуль памяти извлекает наиболее похожий элемент памяти, чтобы получить представление z. Из-за ограничения объема памяти и технологии разреженной адресации одновременно может быть адресовано только небольшое количество элементов внутренней памяти. (поэтому эффективное поведение модуля памяти можно объяснить следующим образом. На этапе обучения декодер в Memory AE ограничен использованием очень небольшого количества адресуемых элементов памяти для реконструкции, что требует эффективного использования элементов памяти. (поэтому , во время реконструкции модуль памяти должен быть принудительно записан для записи наиболее репрезентативного режима прототипа во входном нормальном режиме.На этапе тестирования, учитывая обученную память, для реконструкции может быть извлечен только нормальный режим в памяти.(поэтому , нормальные выборки могут быть лучше восстановлены.И наоборот, закодированное значение аномального входа может быть заменено извлеченным нормальным образцом, что приводит к большой ошибке реконструкции в аномальной выборке.
2.3. Обучение. Дан набор данных, содержащий образцы xi? ?TI�1, пусть xi′ обозначает выборки реконструкции xi в обучающих выборках; минимальный рефакторинг выполняется следующим образом:

(e l2 норма используется для измерения ошибки реконструкции; wi 'представляет собой вес адресации памяти для каждой выборки xi. Чтобы еще больше повысить разреженность w ', разреженная регуляризация минимизируется во время обучения. Учитывая, что все w 'неотрицательны и ‖w′‖1 � 1, задача оптимизации формируется следующим образом:

Путем объединения функции потерь уравнения (7) и уравнения (8) целевая функция Memory AE выглядит следующим образом:

вот гиперпараметр в тренировочном процессе. На практике установлено значение 0.0002. В процессе обучения память обновляется посредством обратного распространения ошибки и градиентного спуска. При обратном распространении ненулевым может быть только градиент элемента памяти с ненулевым весом адресации.
2.4. Тест. После обучения модели ошибка реконструкции пикселя в положении (x, y) кадра зубов t может быть рассчитана по следующему уравнению:

где h(·) представляет всю модель. Учитывая ошибку восстановления десятого кадра на уровне пикселей, ошибку восстановления всего кадра изображения можно получить путем суммирования e(t) � . (х, у)е(х, у, t). (en, оценка аномалии кадра может быть рассчитана следующим образом:

Наконец, можно установить пороговое значение, чтобы определить, является ли оно ненормальным, поскольку s(t) > θ.
3. Эксперимент
В этом разделе проверяется эффективность предлагаемого метода и сравнивается с другими существующими методами. В настоящее время для экспериментов используются два общедоступных набора данных, т. е. набор данных Avenue и набор данных ShanghaiTech. (в качестве показателей количественной оценки используются площадь под кривой на уровне кадра (AUC) и EER.
3.1. Подготовка. (Набор данных e Avenue использует стационарную камеру с разрешением 640 × 360 пикселей для захвата и записи уличной активности Городского университета Гонконга. (Набор данных e Computational Intelligence and Neuroscience 3 включает 16 обучающих видеоклипов, содержащих нормальное поведение тестовых видеороликов, содержащих аномальные события и поведение человека, всего 30652 кадра, и все тестовые видеоролики имеют аннотации целевого уровня, то есть для обозначения аномалий в пространственных локациях используется прямоугольная область. на тротуаре, в то время как аномальные события — это люди, которые мусорят/выбрасывают предметы, блуждают, подходят к камере, ходят по траве и выбрасывают предметы (набор данных ShanghaiTech представляет собой очень сложную коллекцию для обнаружения аномальных событий. В отличие от других наборов данных, он содержит 13 различных сцены с различными условиями освещения и углами камеры, включая в общей сложности 330 обучающих видеороликов и 107 тестовых видеороликов (набор тестов содержит в общей сложности 130 аномальных событий с аннотациями на уровне пикселей. (Весь набор данных содержит в общей сложности 316 154 кадра, в том числе 274 515 кадров в обучающем наборе, 42 883 кадра в тестовом наборе и 17 090 кадров в аномальном кадре (разрешение каждого видеокадра составляет 480 × 856). протестировано на платформе с аппаратной платформой NVIDIA GTX1080TI и видеопамятью 8 ГБ, а программная среда — PyTorch и Python 3.6.Для измерения эффективности метода обнаружения видеоаномалий, предложенного в данной статье, AUC на уровне кадра кривая рабочих характеристик приемника (ROC) используется в качестве индекса оценки.Для индикаторов оценки на уровне кадра, если хотя бы один пиксель кадра помечен как ненормальный, кадр считается ненормальным.И AUC уровня кадра рассчитывается путем сравнения результат обнаружения на уровне кадра с уровнем кадра реальной метки.
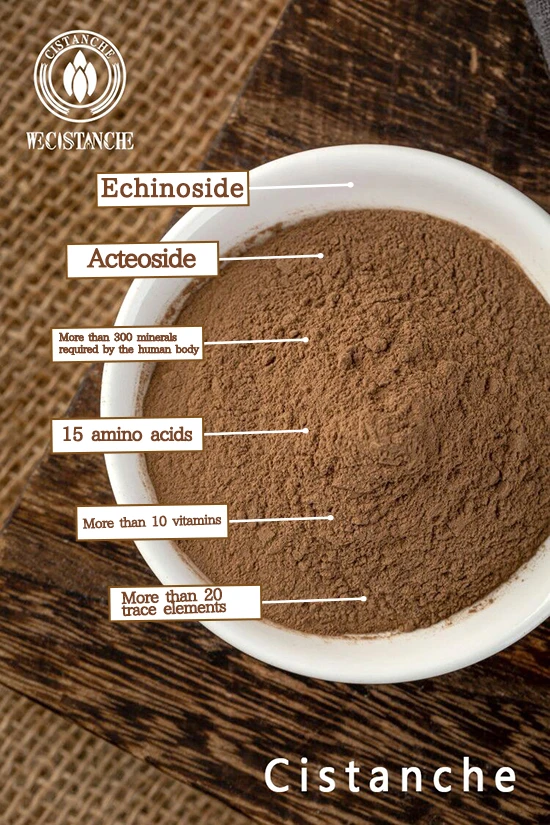
Основные химические составляющие цистанхе пустынной
Нажмите здесь, чтобы просмотреть продукты Cistanche
【Запросите дополнительную информацию】 Электронная почта: cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
3.2. Экспериментальная установка. Все видеокадры корректируются до размера 227 × 227, а затем преобразуются в изображения в градациях серого. (e вход модели 227×227×5, то есть на вход модели используется 5 последовательных кадров. После каждого сверточного слоя идет слой пакетной нормализации и слой возбуждения ReLU. (e декодер включает 4 слоя деконволюции. (Модуль внимания позволяет каждому сегменту памяти записывать функцию в пикселе на карте функций, соответствующую подобласти видеосегмента. (поэтому модуль памяти представляет собой 10 Матрица 00 × 64. (Оптимизатор Адама выбран для оптимизации всех параметров модели. (e начальная скорость обучения составляет 0,0001, а количество итераций равно 1000. (e параметр импульса равен ρ1 ≤ 0,9 и ρ2 ≤ 0,999, объем партии 128 шт.
3.3. Результаты эксперимента. Чтобы доказать эффективность предложенного метода обнаружения видеоаномалий, в этой статье он сравнивается с 12 различными существующими методами. Среди них MPPCA (гибрид вероятностного анализатора главных компонент) плюс SF (социальная сила) [17] и MDT (гибрид динамической текстуры) [18] являются методами, основанными на ручных функциях; Conv-AE [8], 3D Conv [19], Stacked RNN [20] и ConvLSTM-AE [21], MemNormality [10] и ClusterAE [22] — все эти методы основаны на автоэнкодерах; AbnormalGAN [7] и Pred plus Recon [23] основаны на методе генерации состязательных сетей. В таблице 1 показаны результаты обнаружения аномалий видео на уровне кадров различными методами. Можно заметить, что по результатам двух наборов данных метод, основанный на AE, обычно лучше, чем метод, основанный на ручных функциях, и получаются более высокие AUC на уровне кадра. (это связано с тем, что ручные функции обычно извлекаются на основе других задач и, следовательно, могут быть неоптимальными. В методах на основе AE ConvLSTM-AE лучше, чем Conv-AE, потому что первый может лучше собирать информацию о времени. Кроме того, он также может следует отметить, что методы, основанные на GAN, работают лучше, чем большинство базовых методов.Наконец, метод Memory AE, предложенный в этой статье, достигает 85,7% AUC на уровне кадра в наборе данных Avenue, что на 0,6% выше, чем у наиболее эффективного метода Pred plus Recon. [23], в то время как метод, предложенный в этой статье, достиг 75,3% AUC на уровне кадра в наборе данных ShanghaiTech, что на 2% выше, чем у других методов в AUC на уровне кадра, и эффект очень очевиден (в основном потому, что Предлагаемый метод, основанный на Memory AE, использует фрагменты памяти, которые могут хорошо восстанавливать аномалии и вносить некоторые случайные ошибки. Кроме того, по сравнению с набором данных Avenue, набор данных ShanghaiTech достиг более высокого уровня AUC на уровне кадра (в основном потому, что набор данных ShanghaiTech содержит множественные сцены и аномальные события, которые ранее не появлялись в других наборах данных, что является более сложным. Чтобы проверить результаты обнаружения одной сцены в наборе данных ShanghaiTech, для обучения и тестирования используется сегмент видео с одной сценой. 83 сегмента (25 процентов) используются для обучения, а 34 сегмента (32 процента) используются для тестирования, достигая 86,3 процента AUC на уровне кадра, который достиг уровня, аналогичного уровню в наборе данных Avenue. Таким образом, предлагаемый метод Memory AE можно гибко применять к различным типам данных. Только за счет использования ошибок реконструкции предлагаемый метод может получить лучшие результаты с наименьшими специфическими знаниями. Чтобы оценить производительность предопределенного модуля памяти при обнаружении аномальных видеособытий, следующим шагом является изменение размера модуля памяти и проведение экспериментов с набором данных Avenue, а значения AUC на уровне кадров приведены в таблице 2. Это Можно обнаружить, что при достаточно большом размере модуля памяти метод Memory AE может надежно давать наилучшие результаты. Когда размер модуля памяти больше 1000, влияние на результат обнаружения незначительно, но использование большего размера модуля памяти приведет к большему объему вычислений, поэтому размер модуля памяти выбран равным 1000. Рисунки 2(a) и 2(b), соответственно, показывают некоторые результаты обнаружения в наборе данных Avenue и наборе данных ShanghaiTech. (e Таблица 1: Сравнение с современными методами с точки зрения AUC.

лучше, чем метод, основанный на ручных функциях, и получаются более высокие AUC на уровне кадра. (это связано с тем, что ручные функции обычно извлекаются на основе других задач и, следовательно, могут быть неоптимальными. В методах на основе AE ConvLSTM-AE лучше, чем Conv-AE, потому что первый может лучше собирать информацию о времени. Кроме того, он также может следует отметить, что методы, основанные на GAN, работают лучше, чем большинство базовых методов Наконец, метод Memory AE, предложенный в этой статье, достигает 85,7% AUC на уровне кадра в наборе данных Avenue, что на 0,6% больше, чем у самый эффективный метод Pred plus Recon [23]; в то время как метод, предложенный в этой статье, достиг 75,3% AUC на уровне кадра в наборе данных ShanghaiTech, что на 2% выше, чем у других методов в AUC на уровне кадра, и эффект очень очевиден. (в основном потому, что предлагаемый метод, основанный на Memory AE, использует фрагменты памяти, которые могут хорошо восстанавливать аномалии и вносить некоторые случайные ошибки. Кроме того, по сравнению с набором данных Avenue, набор данных ShanghaiTech достиг более высокого уровня AUC на уровне кадра. в основном потому, что набор данных ShanghaiTech содержит несколько сцен и аномальных событий, которые ранее не появлялись в других наборах данных, что является более сложным. Чтобы проверить результаты обнаружения одной сцены в наборе данных ShanghaiTech, для обучения и тестирования используется сегмент видео с одной сценой. 83 сегмента (25 процентов) используются для обучения, а 34 сегмента (32 процента) используются для тестирования, достигая 86,3 процента AUC на уровне кадра, который достиг уровня, аналогичного набору данных Avenue. Таким образом, предлагаемый метод Memory AE можно гибко применять к различным типам данных. Только за счет использования ошибок реконструкции предлагаемый метод может получить лучшие результаты с наименьшими специфическими знаниями. Чтобы оценить производительность предопределенного модуля памяти при обнаружении аномальных видеособытий, следующим шагом является изменение размера модуля памяти и проведение экспериментов с набором данных Avenue, а значения AUC на уровне кадров приведены в таблице 2. Это Можно обнаружить, что при достаточно большом размере модуля памяти метод Memory AE может надежно давать наилучшие результаты. Когда размер модуля памяти больше 1000, влияние на результат обнаружения незначительно, но использование большего размера модуля памяти приведет к большему объему вычислений, поэтому размер модуля памяти выбран равным 1000. Рисунки 2(a) и 2(b), соответственно, показывают некоторые результаты обнаружения в наборе данных Avenue и наборе данных ShanghaiTech. (кадры в зеленой рамке — это нормальные кадры из обычных видеоклипов, а кадры в красной рамке — аномальные кадры из аномальных видеоклипов. Некоторые аномальные события, такие как падение конфетти, езда на велосипеде по тротуару, побои и т. д., могут быть обнаруженным.
Таблица 2: (влияние количества памяти на экспериментальные результаты набора данных Avenue (AUC на уровне кадра/проценты).

Рисунок 2: Примеры результатов обнаружения. (а) Пример из набора данных Avenue. (b) Пример из набора данных ShanghaiTech.

4. Вывод
(В этой статье предлагается Memory AE для повышения производительности обнаружения аномалий больших данных в видео. При наличии входных данных предлагаемый метод Memory AE сначала использует кодировщик для получения кодированного представления, а затем использует код в качестве запроса для извлечения наиболее релевантных данных. паттерны в модуле памяти для реконструкции.Поскольку модуль памяти обучен записывать типичные нормальные паттерны, предлагаемый Memory AE может хорошо восстанавливать нормальные образцы и увеличивать ошибку реконструкции аномалий, что усиливает роль ошибки реконструкции как стандарта обнаружения аномалий. Эксперименты на двух наборах данных доказывают универсальность и эффективность предлагаемого метода.В дальнейшем мы будем изучать использование весов адресации для обнаружения аномалий.Учитывая, что предлагаемый модуль памяти является универсальным и не имеет ничего общего со структурой кодировщика и декодер, он будет интегрирован в более сложную базовую модель и использован в экспериментах с более сложными наборами данных.
Добавка Cistanche рядом со мной-улучшение памяти
Рекомендации
[1] Ф. Донг, Ю. Чжан и С. Ни, «Генерирующая состязательная сеть с двойным дискриминатором для обнаружения аномалий видео», IEEE Access, vol. 8, стр. 88170–88176, 2020.
[2] К. Доши и Ю. Йилмаз, «Последовательное обнаружение аномалий любого кадра в видео наблюдениях», в Proceedings of CVPRW, стр. 934-935, Сиэтл, Вашингтон, США, июнь 2020 г.
[3] К. Доши и Ю. Йилмаз, «Непрерывное обучение обнаружению аномалий в видео наблюдениях», в Proceedings of CVPRW, стр. 254-255, Сиэтл, Вашингтон, США, июнь 2020 г.
[4] К. Джаянта, «Дутта и Бонни Банерджи. Онлайн-обнаружение аномальных событий с использованием возрастающей длины кодирования», в Proceedings of the AAAI, стр. 3755–3761, Остин, Техас, США, январь 2015 г.
[5] Y. Feng, Y. Yuan и X. Lu, «Изучение моделей глубоких событий для обнаружения аномалий толпы», Neurocomputing, vol. 219, стр. 548–556, 2017.
[6] Д. Гонг, Л. Лю, В. Ле и др., «Запоминание нормальности для обнаружения аномалий: глубокий автокодировщик с расширенной памятью для обнаружения аномалий без присмотра», в Трудах ICCV, стр. 1705–1714, Сеул, Корея, октябрь 2019 г.
[7] М. Раванбахш, М. Наби, Э. Санджинето, Л. Марсенаро, К. Регаццони и Н. Себе, «Обнаружение аномальных событий в видео с использованием генеративных состязательных сетей», в материалах Международной конференции IEEE по обработке изображений. , стр. 1577–1581, Пекин, Китай, сентябрь 2017 г.
[8] М. Хасан, Дж. Чой, Дж. Нейманн, А. К. Рой-Чоудхури и Л. С. Дэвис, «Изучение временной регулярности в видеопоследовательностях», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, стр. 733– 742, Лас-Вегас, Невада, США, июнь 2016 г.
[9] В. Лю, В. Луо, Д. Лиан и С. Гао, «Предсказание будущего кадра для обнаружения аномалий — новая основа», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, стр. 6536– 6545, Солт-Лейк-Сити, Юта, США, июнь 2018 г.
[10] Х. Парк, Дж. Но и Б. Хэм, «Изучение нормальности на основе памяти для обнаружения аномалий», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, стр. 14 372–{{ 3}}, Сиэтл, штат Вашингтон, США, июнь 2020 г.
[11] М. З. Захир, Дж.-Х. Ли, М. Астрид и С.-И. Ли, «Старое — это золото: переопределение парадигмы обучения одноклассового классификатора, изученного состязательно», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, стр. 14 183–214 193, Сиэтл, Вашингтон, США, июнь 2020 г.
[12] X. Zhu, J. Liu, J. Wang, Y. Fang и H. Lu, «Обнаружение аномалий в многолюдных сценах с помощью совместного моделирования внешнего вида и динамики», в Proceedings of the IEEE International Conference on Image Processing, стр. 2705–2708, Мельбурн, Виктория, Австралия, сентябрь 2013 г.
[13] RVHM Colque, CAC J'unior и WR Schwartz, «Гистограммы оптической ориентации и величины для обнаружения аномальных событий в видео», в материалах конференции Sibgrapi по графике, шаблонам и изображениям, стр. 126–133. , Сальвадор, Баия, Бразилия, август 2015 г.
[14] Бо Зонг, С. Ци, Р. М. Мартин и др., «Смешанная модель Гаусса с глубоким автокодированием для неконтролируемого обнаружения аномалий», в материалах Международной конференции по обучающим представлениям, Ванкувер, Канада, апрель 2018 г.
[15] М. Сабокру, М. Файяз, М. Фати, З. Моайед и Р. Клетт, «Глубокая аномалия: полностью сверточная нейронная сеть для быстрого обнаружения аномалий в многолюдных сценах», «Компьютерное зрение и понимание изображений», том. 172, стр. 88–97, 2018.
[16] C. Li, Z. Han, Q. Ye и J. Jiao, «Обнаружение визуального аномального поведения на основе анализа разреженной реконструкции траектории», Neurocomputing, vol. 119, нет. 7, стр. 94–100, 2013.
[17] В. Махадеван, В. Ли, В. Бхалодия и Н. Васконселос, «Обнаружение аномалий в многолюдных сценах», в материалах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), стр. 1975–1981, IEEE, Сан-Франциско, Калифорния, США, июнь 2010 г.
[18] В. Ли, В. Махадеван и Н. Васконселос, «Обнаружение и локализация аномалий в многолюдных сценах», IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 36, стр. 18–32, 2014.
[19] Ю. Чжао, Б. Дэн, К. Шен, Ю. Лю, Х. Лу и Х.-С. Хуа, «Пространственно-временной автоэнкодер для обнаружения видеоаномалий», в материалах Международной конференции ACM по мультимедиа (ACM MM), стр. 1933–1941, ACM, Маунтин-Вью, Калифорния, США, октябрь 2017 г.
[20] В. Луо, Л. Вен и С. Гао, «Пересмотр обнаружения аномалий на основе разреженного кодирования в многослойной структуре RNN», в материалах Международной конференции IEEE по компьютерному зрению (ICCV), Венеция, Италия, октябрь. 2017.
[21] В. Луо, Л. Вен и С. Гао, «Вспоминая историю с помощью сверточной LSTM для обнаружения аномалий», в материалах Международной конференции IEEE по мультимедиа и выставкам (ICME), стр. 439–444, IEEE, Гонконг, июль 2017 г.
[22] Ю. Чанг, З. Ту, В. Се и Дж. Юань, «Глубокий автоэнкодер, управляемый кластеризацией, для обнаружения видеоаномалий», в материалах Европейской конференции по компьютерному зрению (ECCV), стр. 329–345, Спрингер, Глазго, Великобритания, август 2020 г.
[23] Л. Вэнь, В. Луо, Д. Лиан и С. Гао, «Предсказание будущего кадра для обнаружения аномалий — новая основа», в материалах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), стр. 6536–6545, IEEE, Солт-Лейк-Сити, Юта, США, июнь 2018 г.
[24] М. Сонг, «Обзор среднего поля ландшафта двухслойных нейронных сетей», Труды Национальной академии наук, том. 115, нет. 33, стр. E7665–E7671, 2018.
[25] Б. Дин и Г. Вен, «Классификатор ближайшего подпространства ограничения разреженности для распознавания целей изображений SAR», Журнал визуальных коммуникаций и представления изображений, том. 52, стр. 170–176, 2018.
[26] Т. Ван и Х. Снусси, «Обнаружение аномальных визуальных событий с помощью гистограммы глобальной оптической ориентации», IEEE Transactions on Information Forensics and Security, vol. 9, нет. 6, стр. 988–998, 2014.