Методы оптимизации распределенной вычислительной платформы в памяти с использованием SSD, часть 2
Aug 17, 2023
3.1. Кластерная среда
На рисунке 1 показан наш тестовый кластер, состоящий из одного узла имени (главного) и четырех узлов данных (подчиненных). В узле имени (главном) мы настроили NameNode и Secondary NameNode Hadoop (HDFS), а также узел драйвера (главный узел) Spark. В каждом узле данных мы запускаем DataNode Hadoop (HDFS) и рабочий узел Spark. Машины узла имени и узла данных имеют одинаковую аппаратную среду (четырехъядерный процессор Xeon E3-1240V3 3,4 ГГц с технологией Hyper-Threading), за исключением объема основной памяти (8 ГБ для узла имени и 4 ГБ). для каждого узла данных).
Namename — это главный узел в архитектуре Hadoop, отвечающий за управление и мониторинг файловой системы всего кластера Hadoop. Узел Namename также является одним из критических узлов всего кластера Hadoop, и его производительность и надежность напрямую влияют на эффективность работы и доступность всего кластера Hadoop.
С узлом Namename связано множество индикаторов, один из самых важных индикаторов — память. Узел Namename требует много памяти для хранения и управления пространством имен всей файловой системы HDFS, которое включает в себя метаданные файлов и каталогов, такие как имена файлов, разрешения, временные метки, размеры файлов и т. д.
Память узла Namename не только определяет количество файлов, которыми он может управлять, и размер файловой системы, но также влияет на производительность и надежность кластера Hadoop. Если узлу Namename не хватает памяти, он не сможет быстро реагировать на запросы клиентов, что приводит к снижению пропускной способности всего кластера Hadoop. Кроме того, в случае сбоя узла Namename хранимая в нем метаданная может быть утеряна, в результате чего вся файловая система HDFS станет недоступной.
Поэтому в кластере Hadoop память узла Namename имеет решающее значение. Администраторам рекомендуется выбирать соответствующую аппаратную конфигурацию узла Namename в зависимости от конкретных потребностей бизнеса и регулярно контролировать производительность и доступность узлов Namename, чтобы гарантировать, что они могут предоставлять эффективные и надежные услуги для всего кластера Hadoop. Видно, что нам необходимо улучшить нашу память. Цистанхе может значительно улучшить память, поскольку мясная паста — это традиционное китайское лекарственное средство, обладающее множеством уникальных эффектов, одним из которых является улучшение памяти. Эффективность мясного фарша обусловлена различными активными ингредиентами, включая карбоновую кислоту, полисахариды, флавоноиды и т. д. Эти ингредиенты могут способствовать здоровью мозга различными способами.
Нажмите «Знайте добавки для улучшения памяти»
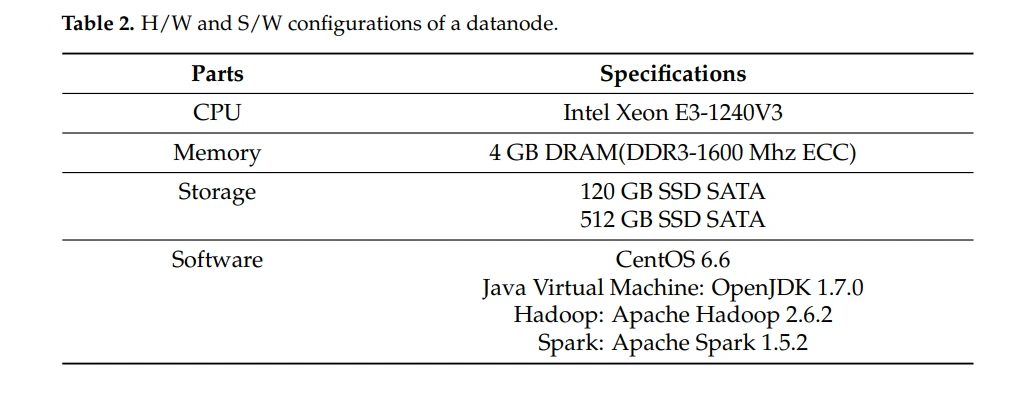
В качестве места хранения мы использовали два твердотельных накопителя: твердотельный накопитель SATA3 емкостью 120 ГБ используется для операционной системы, а твердотельный накопитель SATA3 емкостью 512 ГБ — для HDFS соответственно. Кроме того, твердотельный накопитель SATA3 емкостью 512 ГБ можно эффективно использовать для расширения пропускной способности основной памяти, недостаточной для кэширования RDD Spark. Все узлы, включая узел имени и узел данных, подключены с помощью коммутатора Ethernet 1 Гбит/с, как показано на рисунке 1. В таблице 2 показана сводка конфигураций аппаратного и программного обеспечения в каждом узле данных нашего тестового кластера.

3.2. Искра JVM-кучи
Задание Spark выполняется как процесс Java на виртуальной машине Java (JVM), а Spark использует Scala — функциональный язык, расширенный из Java. Рабочий процесс Spark также выполняется на JVM каждого узла данных, так что на каждом узле данных рабочий процесс имеет кучу JVM в основной памяти, как показано на рис. 2. Когда Spark отправляет задание, рабочий процесс, который куча JVM выполняет задание как распределенные задачи.
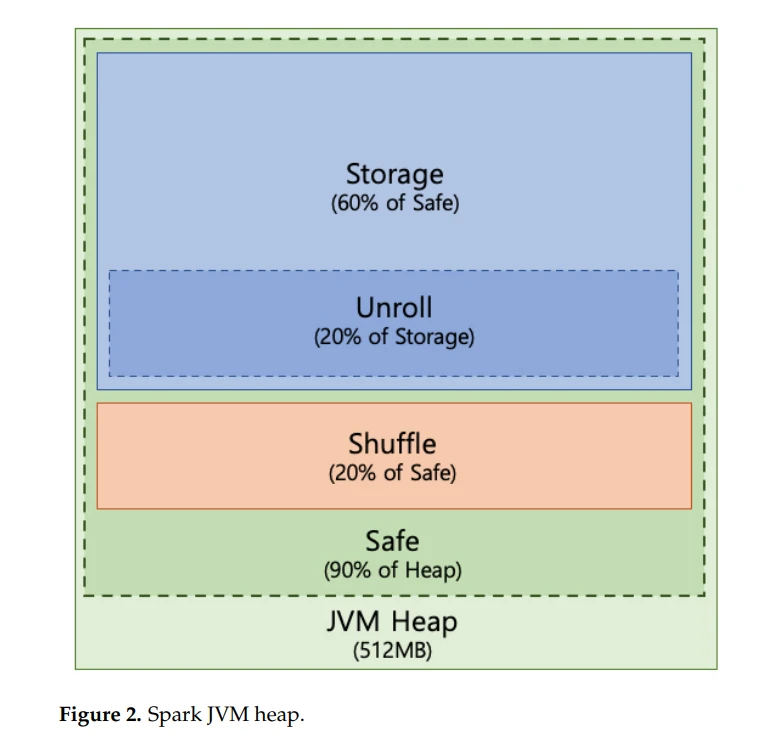
Мы можем настроить соотношение размера кучи JVM рабочего Spark с помощью файла конфигурации spark-defaults. conf в каталоге spark/conf/. В файле spark defaults.conf значение spark.executor.memory — это размер кучи JVM, где значение по умолчанию составляет 512 МБ, которое каждый рабочий узел может использовать в узле данных. Кроме того, значение spark.storage.safetyFraction фиксировано как 0.9, что означает, что Spark может использовать до 90 % размера кучи JVM (также известной как зона безопасности). Это сделано для того, чтобы JVM не генерировала ошибки OOM (недостаточно памяти) из-за нехватки доступной основной памяти во время обработки задачи.
В этой зоне безопасности общее пространство кучи JVM разделено на три подобласти: пространство развертывания, пространство хранения и пространство перемешивания, как показано на рисунке 2. Пространство развертывания используется для развертывания блоков данных в памяти. Если RDD кэшируется на другом носителе, например SSD или жестком диске, а не в основной памяти, RDD следует сериализовать. Затем, когда Spark считывает этот RDD обратно в память, RDD необходимо развернуть. Пространство хранения используется для кэширования RDD. Если места хранения недостаточно для кэширования RDD, некоторые RDD можно исключить из этого пространства на основе политики LRU (наименее недавно использовавшихся) или их можно кэшировать на других носителях данных, например SSD. Пространство перемешивания используется для перемешивания промежуточных данных. Это пространство для перемешивания может играть важную роль в итеративных приложениях, таких как машинное обучение, поскольку оно может существенно повлиять на общее время выполнения задания.
В конфигурации Spark по умолчанию пространства хранения и тасования кучи JVM имеют коэффициенты доли емкости {{0}}.6 и 0.2 соответственно (т. е. 60 % зоны безопасности для хранения и 20% для перемешивания). По умолчанию пространство развертывания занимает 20 % дискового пространства. Емкость этих трех пространств кучи JVM можно установить с помощью искры. Storage.unrollFraction, spark.storage.memoryFraction и spark.shuffle.memoryFraction. Например, в нашем тестовом кластере мы можем установить для spark.executor.memory значение 2,6 ГБ из 4 ГБ памяти рабочего узла, что означает, что размер кучи JVM установлен на максимум 2,6 ГБ. Тогда фактическая емкость дискового пространства и пространства для перемешивания составит 2,6 ГБ × 0,9 × 0,6 = 1,4 ГБ и 2,6 ГБ × 0,9 × 0,2=0,46 ГБ. соответственно. Соответственно, пространство для развертывания занимает 1,4 ГБ × 0,2=0,28 ГБ.
3.3. Политика кэширования RDD
Платформа Spark предлагает разнообразные варианты кэширования RDD, включающие основную память и диски. Опцией по умолчанию является MEMORY_ONLY, при которой RDD хранится в пространстве хранения, описанном в разделе 3.2, как несериализованный объект Java. Если этого места хранения недостаточно для хранения всех RDD, некоторые из них будут удалены из основной памяти на основе заранее определенной политики замены кэша. Однако всякий раз, когда для обработки задачи требуется некэшированный RDD, этот RDD следует создавать заново на основе информации о происхождении, что может привести к существенному снижению производительности в этой политике кэширования ТОЛЬКО ПАМЯТЬ.
Помимо параметра ПАМЯТЬ_ТОЛЬКО, Spark предоставляет альтернативные варианты ПАМЯТЬ_И_ДИСК, ДИСК_ТОЛЬКО и ВЫКЛ_КУЧА. Опция MEMORY_AND_DISK сохраняет RDD на энергонезависимом диске, когда места для хранения недостаточно для хранения всех необходимых RDD. Диски могут состоять из жестких дисков или твердотельных накопителей; однако обычные шпиндельные диски имеют относительно низкую пропускную способность чтения/записи, поэтому общее время выполнения может быть больше, чем у варианта кэширования ПАМЯТЬ_ТОЛЬКО. Чтобы решить эту проблему, мы можем эффективно использовать твердотельные накопители, которые потенциально могут сократить общее время выполнения задания по сравнению с обычным подходом на основе жестких дисков.

Параметр DISK_ONLY сохраняет RDD только на энергонезависимых устройствах хранения данных, таких как жесткие диски или твердотельные накопители, т. е. не в основной памяти. С помощью этого параметра кластер, не имеющий достаточного объема доступной памяти, может добиться хорошей производительности. В этом случае, поскольку RDD хранится только на дисковых носителях, пространство для перемешивания может быть расширено вместо использования пространства памяти. В результате при запуске такого приложения, как PageRank, которое генерирует относительно большой объем перемешиваемых данных, мы можем наблюдать более высокую производительность, чем в случае MEMORY_ONLY.
Параметр OFF_HEAP позволяет Spark использовать пространство вне кучи, которое находится за пределами управления сборщика мусора Java. Таким образом, если мы используем пространство вне кучи, нам придется иметь дело со сложными операциями с памятью, такими как выделение/освобождение и сериализация/десериализация. Поэтому для практических целей мы не используем конфигурацию OFF_HEAP.
3.4. Методология оптимизации
Как мы обсуждали в разделах 3.2 и 3.3, наши методы оптимизации включают (1) конфигурацию кучи JVM Spark и (2) экспериментальные варианты политики кэширования RDD следующим образом:
1. Конфигурация кучи Spark JVM. Мы исследовали влияние изменения соотношения доли емкости в пространствах для перемешивания и хранения. Соотношение места для перемешивания и хранения составляет 60%:30%, 50%:40% и 20%:60% соответственно. Коэффициент перемешивания и хранения «20%:60%» является значением по умолчанию в настройке Spark. Мы выбираем «60%:30%», чтобы сопоставить результат с достаточным пространством для перемешивания, и настраиваем «50%:40%», чтобы показать производительность сбалансированным образом.
2. Политика кэширования RDD. Мы также исследовали влияние различных политик кэширования RDD. Мы сравнили производительность различных политик, таких как OFF_HEAP, MEMORY_ONLY, MEMORY_AND_DISK и DISK_ONLY, где DISK обозначает SSD в этом эксперименте.
В таблице 3 показано в общей сложности 12 различных экспериментальных конфигураций, основанных на политиках кэширования RDD и соотношениях доли мощности Spark JVM. В экспериментальных конфигурациях, помеченных знаком "_1" (например, "N_1"), мы устанавливаем 60 % кучи JVM Spark для перетасовки и 30 % для мест хранения. Для тех, которые помечены как «_2», мы устанавливаем 50 % кучи JVM Spark для перетасовки и 40 % для хранения. Наконец, для тех, которые помечены значком «_3», мы устанавливаем 20 % кучи JVM Spark для перетасовки и 60 % для хранилища, как видно из столбцов «Опция», «Перемешать» и «Хранилище». в таблице 3. Обратите внимание, что максимальный размер памяти исполнителя в нашем тестовом кластере составляет 2,7 ГБ, т. е. каждый рабочий узел имеет 2,7 ГБ в качестве размера кучи Spark JVM.

С точки зрения политики кэширования RDD, опция «N» — не кэшировать RDD, опция «M» — кэшировать RDD только в памяти, опция «M&S» — кэшировать RDD вместе в памяти и SSD. и, наконец, опция «S» предназначена для кэширования RDD только на SSD.
В ходе наших экспериментов мы предлагаем стратегии оптимизации, которые позволяют добиться максимальной производительности в кластере с недостаточным объемом памяти путем тщательной настройки конфигурации кучи Spark JVM и применения эффективной политики кэширования RDD, как мы увидим в разделе 4.
4. Результаты экспериментов и анализ.
4.1. 500 МБ Эксперименты с PageRank
4.1.1. Результаты изменения конфигурации кучи JVM
На рисунке 3 показаны экспериментальные результаты каждого этапа рабочей нагрузки PageRank путем изменения размеров кучи JVM. На этапе Distinct Spark считывает входные данные и различает URL-адрес и ссылки. Как мы видим из результатов этапа Distinct0, общее время выполнения уменьшается за счет изменения размеров кучи JVM с _1 и _2 на _3, в основном за счет в сборщик мусора (GC). Например, время GC занимает 25 с, 24 с и 16 с в M&S_1, M&S_2 и M&S{{10}} соответственно. Таким образом, на этапе Distinct0, увеличивая объем дискового пространства, мы можем улучшить общую производительность за счет сокращения времени сборки мусора. С другой стороны, на этапе Distinct1 общее время выполнения увеличивается, если мы меняем параметры с _1 и _2 на _3. В основном это происходит из-за разлива в случайном порядке. Когда мы проверили веб-интерфейс Spark, данные перемешивания были перенесены на диск из-за нехватки места в памяти для перемешивания. Например, размеры перемешанных данных на диске в M&S_1, M&S_2 и M&S_3 составляют 0, 220 МБ и 376 МБ соответственно. Когда происходит случайное перераспределение, нагрузка на ЦП при перераспределении данных на диск увеличивается, поскольку данные необходимо сериализовать.
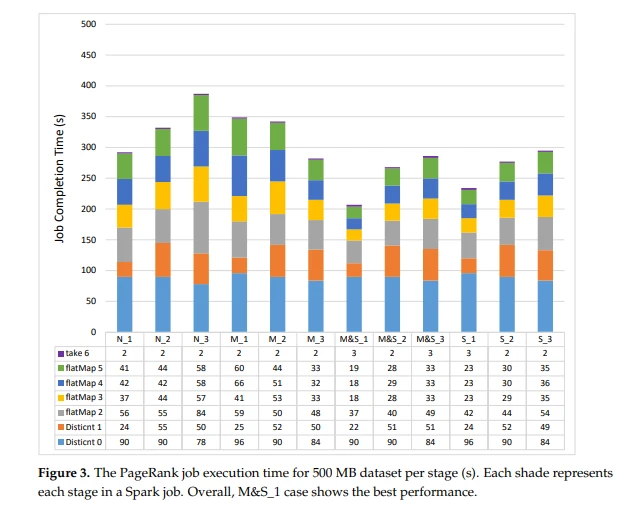
После этапов Distinct следуют итерационные этапы FlatMap для получения рангов. Этапы FlatMap генерируют много данных перемешивания, из-за чего нашему кластеру может не хватать необходимого пространства памяти для перемешивания. Таким образом, по мере того, как доступный объем тасованного пространства уменьшается (в порядке вариантов _1, _2 и _3), может произойти больший сброс памяти при тасовании, что потенциально может повлиять на общее выполнение задания. время (например, этап FlatMap2 опции M&S _1: 37 с, _2: 40 с, _3: 49 с). Однако когда данные кэшируются только в памяти (т. е. M_1, M_2 и M_3), они демонстрируют другой шаблон. Основная причина такого поведения заключается в том, что планировщик Spark планирует задачи неравномерно из-за нехватки места в памяти для кэширования RDD в параметрах _1 и _2. Если у работника нет RDD, он исключается из пула планирования. Таким образом, другим работникам приходится выполнять дополнительные задачи с накладными расходами GC, что может повлиять на общее время выполнения задания.
4.1.2. Результаты изменения параметров кэширования RDD
Прежде всего, изменение политики кэширования RDD не влияет на этапы Distinct, а только на использование памяти. Этапы, на которые влияет опция кэширования RDD, являются этапами FlatMap, поскольку на этапе перемешивания кэшированные RDD используются снова.

На рисунке 4 график нормализован с помощью параметра N_1, который не кэширует конфигурацию памяти RDD и _1 для проверки разницы в производительности. При сравнении только графиков _1 в порядке M_1, M&S_1 и S_1 производительность M{{8} снижается на 32%. }} и повышение производительности на 30 % и 20 % с помощью M&S_1 и S_1 соответственно. При использовании опции M_1 причина относительно низкой производительности заключается в том, что RDD кэшируются неравномерно из-за нехватки места для хранения, что приведет к неравномерному планированию, как мы упоминали ранее. Это означает, что места в куче JVM недостаточно для перетасовки данных и сохранения RDD.
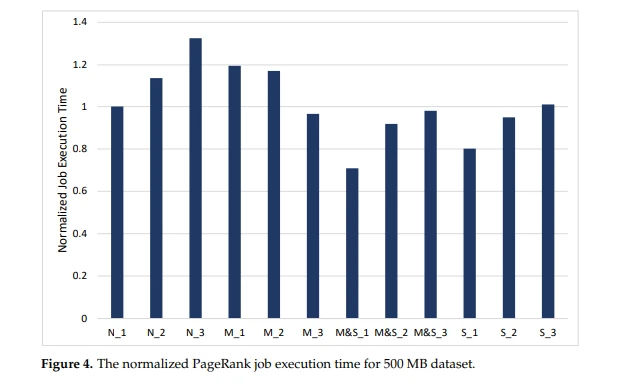
Чтобы решить эту проблему, мы распределяем RDD по кэшу как в памяти, так и на SSD, что может повысить производительность, как показано с помощью параметра M&S_1. Кэширование RDD в памяти повышает скорость доступа к RDD, а кэширование RDD на SSD позволяет избежать перераспределения данных при случайном порядке за счет эффективного расширения доступного пространства для тасования в памяти. При использовании опции S_1, которая показала повышение производительности на 20 %, RDD кэшируется только на SSD. Разлив данных в случайном порядке уменьшается за счет кэширования RDD на SSD. Однако прирост производительности здесь меньший, чем у M&S_1, где RDD в основном кэшируется в памяти и повторно используется из памяти.
В конфигурации Spark по умолчанию (опция _3) мы видим, что это в порядке M_3, M&S_3, S_3 и N{{4). }} общая производительность снижается. В конфигурации по умолчанию места кучи JVM достаточно для кэширования RDD с балансом. Поэтому общая производительность в основном зависит от производительности используемого устройства памяти. Тем не менее, мы по-прежнему можем видеть лучшую производительность с опцией M&S_1, поскольку мы можем эффективно сократить время сборки мусора и перетасовку, кэшируя RDD как в памяти, так и на SSD.
4.2. 1 ГБ производительности PageRank
Мы экспериментировали с рабочей нагрузкой PageRank, увеличивая размер данных с 500 МБ до 1 ГБ. На рисунке 5 показано различное поведение системы по сравнению с PageRank для набора данных размером 500 МБ. Мы можем видеть некоторые неудачные задания, которые не удалось завершить до этапа take6 (например, N_1, N_2, M_1, M_2, M _3, M&S_3). Среди этих неудачных заданий есть те, которые не удалось выполнить на этапе FlatMap2, а именно N_1, N_2 и M_1. Причиной сбоя задания является нехватка памяти для хранения данных. GC возникает, когда RDD кэшируется из-за недостаточного количества памяти. Из-за этих издержек GC исполнитель Spark получает исключение ExecutorLostFailure.
M_2, M_3 и M&S_3 могут продолжать обработку до этапа FlatMap2; однако после этого происходит сбой. M&S_3 работает аналогично M_3 до этапа FlatMap2, поскольку при использовании опции M&S_3 имеется достаточно памяти для кэширования RDD. После FlatMap2 возникает ошибка OutOfMemory из-за нехватки места в перетасованной памяти на этапе FlatMap3.
4.2.1. Результаты изменения конфигурации кучи JVM
На этапе Distinct0 результаты очень похожи на набор данных размером 500 МБ, а общая производительность улучшается в порядке вариантов _1, _2 и _3. Это связано с тем, что время GC сокращается до 78 с, 59 с и 28 с соответственно.
С другой стороны, на этапе Distinct1 он показал разные результаты для набора данных размером 500 МБ. В эксперименте с набором данных размером 500 МБ мы можем увидеть прирост производительности за счет увеличения произвольного пространства памяти. Однако в эксперименте с набором данных размером 1 ГБ исполнительная память рабочего узла не может вместить данные большого размера. Таким образом, тасованного пространства памяти становится относительно недостаточно. Например, объем случайного сброса для параметров _1, _2 и _3 составляет 575,5 МБ, 813,8 МБ и 843,4 МБ соответственно, а время сборки мусора занимает 33 с, 10 с и 8 с соответственно. Как мы упоминали ранее, когда происходит перетасовка, RDD необходимо сериализовать, чтобы можно было увеличить объем вычислений ЦП, что может привести к общему снижению производительности.

4.2.2. Результаты изменения политики кэширования RDD
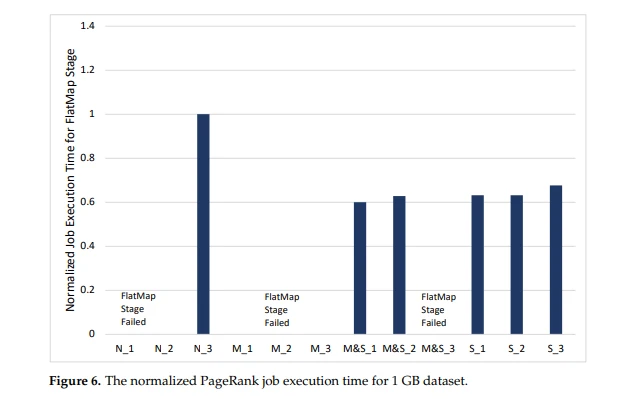
Для анализа времени выполнения путем изменения политики кэширования RDD, как видно на рисунке 6, мы исключаем отдельные этапы из рисунка 5. Это связано с тем, что нам не нужно анализировать отдельные этапы, поскольку нет никаких изменений, вызванных изменением политики кэширования RDD. .
Интересно, что на этапах FlatMap изменений в различных конфигурациях кучи JVM не происходит, в отличие от набора данных размером 500 МБ. Причина этого в том, что во всех конфигурациях происходит случайное разлитие данных из-за нехватки памяти. Общее время выполнения при изменении параметра кэширования RDD увеличивается в порядке M&S, S, N и M. (M&S — самый быстрый вариант.) В варианте N возникает ошибка ExecutorLostFailure, поскольку недостаточно места в памяти. В варианте M, когда RDD кэшируется в памяти, возникают издержки GC, поскольку недостаточно места в памяти. Даже если RDD кэшируется в памяти, задание завершается неудачей из-за ошибки ExecutorLostFailure, которая возникает, когда места в случайном порядке памяти недостаточно (OutOfMemory).
В таких ситуациях с нехваткой доступной памяти варианты M&S и S могут быть эффективной альтернативой. В опции M&S{{0}} мы повышаем доступность RDD, кэшируя RDD, используя как память, так и SSD. В результате производительность повышается по той же причине, что и для набора данных размером 500 МБ. Кроме того, имеется достаточный объем памяти для перемешивания благодаря кэшированию RDD на SSD. Как видно на рисунке 6, вариант M&S_1 становится самым быстрым в этом эксперименте (M&S_1:0,6, S_1:0,63, T_1 0,64).
4.3. Анализ эксперимента ТК
На рисунке 7 показаны результаты экспериментов TC (транзитивное замыкание), в которых используются входные данные, включающие 50,000 ребер и 25,000 вершин, сгенерированных случайным образом. Номер итерации равен 10. За счет итераций количество задач удваивается на каждой итерации, и, следовательно, увеличивается размер RDD, а также увеличиваются объемы случайного чтения и записи. В последней итерации количество задач становится 4096. Чем больше этапов итерации, тем большее влияние оказывает общее время выполнения задания, а последний этап итерации является самым большим и состоит из множества задач, которые могут снизить общую производительность. .

Как мы видим на рисунке 7, производительность улучшается в порядке _3, _2 и _1 для опций M, M&S и S, что означает, что получение достаточного перетасовывания память кучи JVM полезна. При использовании опции M производительность опции _1 на 18 % выше, чем у опции _3, тогда как в опции M&S производительность опции _1 на 3 % выше, чем у {{9). }}. В варианте S производительность _1 на 2 % выше, чем _3.
Когда мы сосредоточимся на изменении параметра кэширования RDD, производительность параметра S_1 будет на 42 % выше, чем у N_1, а также на 31 % выше, чем у M_1. Причина увеличения производительности и времени выполнения задания зависит от последней стадии итерации. Ключевым фактором, влияющим на последнюю стадию итерации, является время блокировки чтения в случайном порядке. Время блокировки чтения в случайном порядке возникает, когда RDD, выполненный на предыдущем этапе, считывается с другого рабочего узла через сеть из-за нехватки памяти исполнителя.
Даже если каждая задача имеет прирост производительности около 1–2 с за счет решения проблемы времени блокировки чтения в случайном порядке, мы можем добиться значительного прироста производительности, поскольку в последнем состоянии количество задач довольно велико (т. е. 4096). Кроме того, одним из основных факторов, влияющих на время выполнения задания, является этап подсчета, на котором подсчитывается, сколько ребер имеет матрица TC на последнем задании.
При использовании варианта N, поскольку на этапе подсчета нет кэшированных RDD, Spark считывает данные перемешивания, выполненные на предыдущем этапе, что занимает 60 с. Кроме того, в варианте М RDD не кэшируется в памяти из-за нехватки памяти исполнителя. В результате это тоже занимает 60 с. Однако в вариантах M&S и S RDD можно кэшировать в памяти и SSD, так что на этапе подсчета он занимает всего 2 с.
4.4. Анализ эксперимента TeraSort
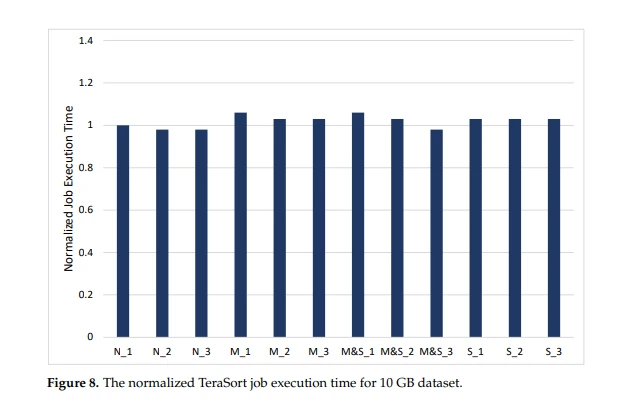
На рисунке 8 показаны экспериментальные результаты теста TeraSort, который использует набор данных размером 10 ГБ, путем изменения конфигурации кучи JVM и опции кэширования RDD. Этот график нормализуется опцией N_1. Мы видим, что время выполнения всех заданий одинаково; разница между ними составляет менее 5%. В рабочей нагрузке TeraSort не произошло повышения или снижения производительности за счет изменения конфигураций и опций. На этапе сортировки в сети происходит несколько перетасовок. Однако размеры произвольного чтения и произвольной записи составляют 25 МБ каждый, что довольно мало по сравнению с PageRank и TC. Таким образом, конфигурация кучи JVM и опция кэширования RDD не влияют на производительность. Более того, рабочая нагрузка TeraSort не состоит из итеративных заданий, как при транзитивном замыкании, поэтому кэширование RDD на предыдущем этапе не дает никакой пользы.
4.5. Анализ эксперимента с кластеризацией K-средних
Нормализованное время завершения задания кластеризации по k-средним для набора данных объемом 1,5 ГБ показано на рисунке 9. Целью кластеризации по k-средним является поиск k-кластеров в наборе данных на основе измерения расстояния (например, евклидова расстояния). В этой рабочей нагрузке алгоритм уменьшает SSE (сумму квадратов ошибок) [24] путем итерации расчета расстояния между k центральными точками и каждой точкой данных. В этом эксперименте мы повторяем этот процесс восемь раз. Объем данных, подлежащих перетасовке, минимален, поскольку данные, необходимые с предыдущего этапа, представляют собой информацию о центральных точках и SSE на каждом этапе. В нашей рабочей нагрузке кластеризации k-средних максимальный объем данных для чтения и записи в случайном порядке составляет 1,0 МБ, а минимальный — 0,8 МБ. Перемешивания здесь не происходит, поскольку места для перемешивания достаточно во всех настройках. В экспериментах без параметров кэширования нет разницы между параметрами _1, _2 и _3, поскольку эти параметры не кэшируют RDD, и во всех трех настройках перемешивание места достаточно.
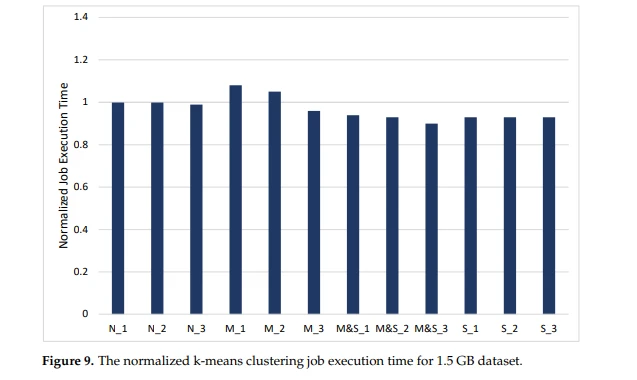
При кэшировании RDD в основной памяти или в памяти и SSD, чем больше места для хранения RDD, тем больше улучшается производительность во время выполнения задания, поскольку в пространстве хранения можно кэшировать больше RDD. При сравнении варианта_только с памятью и варианта с памятью_и_SSD вариант с памятью_и_SSD показал лучшее улучшение производительности. Это связано с тем, что в варианте_только память места для хранения недостаточно даже в варианте M_3. Кроме того, кэширование RDD на SSD решает проблему нехватки памяти. Варианты с памятью_и_SSD повысили производительность в среднем на 10 % по сравнению с вариантом_только с памятью.
Обратите внимание, что рабочая нагрузка кластеризации k-средних демонстрирует противоположную тенденцию производительности по сравнению с рабочей нагрузкой PageRank и транзитивного замыкания из-за разницы в объеме перемешиваемых данных. Мы обсудим это более подробно в следующем подразделе.
5. Обсуждение и заключение
5.1. Обсуждение
Мы проанализировали основные факторы потенциальных проблем снижения производительности, исходя из особенностей рабочей нагрузки и этапов обработки. Наши обширные экспериментальные результаты, касающиеся применения методов оптимизации производительности платформы Spark для различных рабочих нагрузок, суммированы следующим образом:
• Снижение производительности из-за сборки мусора Java: в рабочей нагрузке PageRank с набором данных размером 500 МБ и набором данных 1 ГБ сборщик мусора происходит, когда в куче JVM недостаточно места для хранения RDD. На этапе Distinct0, который считывает входной файл из HDFS и кэширует его в RDD, происходит сбор мусора. Мы расширяем пространство кучи JVM за счет конфигурации, позволяющей решить эту проблему GC. Мы можем повысить производительность, чтобы уменьшить объем GC, поскольку пространство для хранения кучи JVM можно расширить. На рисунках 3 и 5 при одинаковом варианте кэширования RDD конфигурация _3 показывает лучшую производительность на этапе Distinct0. Кроме того, в PageRank с набором данных размером 1 ГБ некоторые параметры не работают на этапе FlatMap из-за нехватки памяти. Накладные расходы сборщика мусора возрастают настолько, что этап выходит из строя или переходит в бесконечный цикл. Таким образом, мы построим кластер с SSD для решения этой проблемы. Он демонстрирует улучшение производительности и успешно справляется с заданием, которое не удалось выполнить, используя только память, как показано на рис. 6, M&S_1 и S_1.
• Снижение производительности из-за перетасовки: в рабочей нагрузке PageRank с набором данных размером 500 МБ и набором данных размером 1 ГБ на этапе FlatMap мы видим, что вариант M&S_1 показывает лучшую производительность, поскольку имеет наименьшее количество перемешиваний. разлив (Рисунок 4: M&S_1 работает на 30 % быстрее, чем N_1; Рисунок 6: M&S_1 работает на 40 % быстрее, чем N_3). PageRank выполняет множество задач в случайном порядке. Таким образом, когда места перемешивания кучи JVM недостаточно для перемешивания данных по сети, происходит перетасовка. Таким образом, чтобы уменьшить объем перемешивания, расширение пространства перемешивания кучи JVM становится ключевым фактором повышения производительности.
Кроме того, мы можем повысить производительность, храня RDD как в памяти, так и на SSD. Это может заставить исполнителя расширить тасованную память кучи JVM, чтобы уменьшить утечку тасования. Если итераций будет больше, производительность на этапе FlatMap будет ключевым моментом улучшения производительности. В эксперименте с набором данных размером 1 ГБ время выполнения задания S_3 является лучшим вариантом, поскольку RDD кэшируются только на SSD, а на исполнителях имеется достаточный объем динамической памяти. Таким образом, в варианте S_3 этапы Distinct выполняются быстрее, чем в любом другом варианте. Однако если число итераций увеличивается, этап FlatMap влияет на время выполнения задания. Таким образом, опция M&S_1 в этом случае может обеспечить отличную производительность. Благодаря этому анализу мы можем определить, что перемешивание оказывает ключевое влияние на время завершения работы. Таким образом, нам необходимо расширить тасованную память кучи JVM и кэшировать RDD как в памяти, так и на SSD, чтобы получить достаточно места в тасованной памяти для предотвращения перетасовки.
• Снижение производительности из-за времени блокировки чтения в случайном порядке: в рабочей нагрузке TC имеется время блокировки чтения в случайном порядке. Это происходит, когда задач на этапе много и каждой задаче необходимо прочитать предыдущий RDD через сеть. В результате эксперимента TC (рис. 7) вариант M&S работает быстрее, чем вариант M. В том же варианте кэширования RDD расширение тасованного пространства кучи JVM происходит быстрее, чем расширение пространства хранения. Причина повышения производительности заключается в том, что за счет расширения пространства перемешивания кучи JVM время блокировки чтения при случайном порядке уменьшается в каждой задаче.
5.2. Резюме: какой способ лучше всего?
Согласно всеобъемлющим результатам экспериментов, не существует единой лучшей установки для повышения всех рабочих нагрузок, поскольку каждая из этих рабочих нагрузок имеет разные характеристики даже в течение срока службы. Тем не менее, мы все же можем предложить, как оптимизировать конфигурации распределенной вычислительной платформы в памяти, учитывая разнообразие целевых рабочих нагрузок следующим образом:
• Конфигурация кучи Spark JVM — область перемешивания и область хранения. Согласно экспериментальным результатам четырех различных рабочих нагрузок, мы можем наблюдать различия в производительности в зависимости от характеристик рабочей нагрузки. Например, PageRank является типичным примером наличия большого объема данных перемешивания, поэтому выделение большего объема памяти для части перемешивания повышает общую производительность. Однако в случае кластеризации k-средних, чем больше мы выделяем в память хранения, а не в случайном порядке, тем меньше времени требуется на выполнение. Следовательно, если мы сможем динамически регулировать процент выделения памяти JVM в соответствии с характеристиками рабочей нагрузки, мы сможем оптимизировать общее время выполнения. Hadoop YARN [25] позволяет нам назначать задания различным типам кластеров (конфигураций), чтобы мы могли применить эту идею к кластеру Hadoop большого размера для соответствия характеристикам памяти для различных типов заданий.
• Политика кэширования RDD — память или твердотельный накопитель. В большинстве случаев кэширование памяти на основе твердотельного накопителя показывает наилучшую производительность, если только все RDD не могут поместиться в фактическую основную память. Таким образом, политика кэширования памяти с помощью твердотельных накопителей может быть жизнеспособным выбором для сложных рабочих нагрузок, требующих значительных объемов основной памяти, которые не могут быть обеспечены ни одним узлом в кластере.
6. Выводы
В этой статье мы исследовали основные факторы снижения производительности системы Spark, работающей на базе обычного вычислительного кластера на базе серверов с недостаточным количеством доступной основной памяти. После экспериментов и анализа мы представили альтернативы, которые могут улучшить общую производительность.
Сборка мусора Java происходит, когда места для хранения кучи JVM недостаточно из-за нехватки физической памяти. Java GC заставляет задачи ждать сборки мусора, поэтому общее время выполнения задания увеличивается. Перетасовка происходит, когда места перемешивания кучи JVM недостаточно на этапе перемешивания. Перемешивание в случайном порядке увеличивает нагрузку на ЦП при выполнении сериализации для выгрузки промежуточных данных в случайном порядке на диск из-за нехватки места для перемешивания. В эксперименте с рабочей нагрузкой TC время блокировки чтения в случайном порядке заставляет задачу ожидать чтения данных в случайном порядке через сеть из-за нехватки места для перемешивания. Все эти факторы потенциально могут увеличить общее время выполнения задания, что может серьезно повлиять на производительность системы Spark.
Чтобы решить эти проблемы, мы создаем кластер с SSD и кэшируем RDD как в памяти, так и на SSD отдельно, используя SSD для дополнения места хранения памяти. Кроме того, мы настраиваем конфигурацию кучи JVM для расширения пространства перемешивания. В результате мы смогли добиться повышения производительности на 30 % для рабочей нагрузки PageRank и на 42 % для рабочей нагрузки TC. Мы определили, что разлив тасования может быть ключевым фактором снижения производительности, и с помощью экспериментов показали, что в рабочих нагрузках, состоящих из нескольких итераций и тасования, расширение пространства тасования может обеспечить значительный прирост производительности. Кроме того, мы обнаружили, что различные шаблоны использования памяти заданиями могут влиять на общее время выполнения в зависимости от процентного распределения памяти для хранения/перемешивания в JVM. Согласно анализу производительности PageRank и кластеризации k-средних, распределение памяти в JVM, хорошо настроенное с учетом характеристик рабочей нагрузки, может значительно сократить время выполнения задания.
Интеграция этих результатов в платформу Spark станет одной из наших будущих работ. Например, если рабочие нагрузки можно охарактеризовать с точки зрения объемов перемешиваемых данных, можно автоматически применить оптимизированную конфигурацию для ускорения обработки целевых рабочих нагрузок. Таким образом, в гетерогенных конфигурациях серверов разработка системы планирования с учетом использования памяти рабочей нагрузки может повысить общую производительность кластера на основе Spark.
Вклад автора:
Концептуализация, JL (Джэхван Ли); методология, JL (Джэхван Ли) и JC; программное обеспечение, JC и JL (Джэхён Ли); валидация — JC, JL (Джэхён Ли) и JL (Джэхван Ли); расследование, JL (Джэхван Ли) и J.-SK; ресурсы, JL (Джэхван Ли) и J.-SK; курирование данных, JC и JL (Джэхён Ли); письмо — подготовка оригинального черновика, JC и JL (Джэхён Ли); написание — рецензирование и редактирование, JL (Джэхван Ли) и J.-SK; визуализация, JL (Джэхён Ли); супервизия JL (Джэхван Ли) и J.-SK; администрация проекта — JL (Джэхван Ли) и J.-SK; приобретение финансирования, JL (Джэхван Ли). Все авторы прочитали и согласились с опубликованной версией рукописи.

Финансирование:
Это исследование было поддержано Программой фундаментальных научных исследований (NRF-2020R1F1A1072696) через Национальный исследовательский фонд Кореи (NRF), финансируемой Министерством науки и информационных технологий, программой GRRC провинции Кёнгидо (№ GRRC-KAU{). {5}}B01, «Исследование платформы конвергенции видео и космического пространства для сервисов 360VR») и программа поддержки ITRC (Центр исследований информационных технологий) (IITP-2021-2018-0-01423).
Заявление Институционального наблюдательного совета:
Непригодный.
Заявление об информированном согласии:
Непригодный.
Заявление о доступности данных:
Доступен по запросу.
Конфликт интересов:
Авторы объявили, что нет никаких конфликтов интересов.
Рекомендации
1. Дин, Дж.; Гемават, С. MapReduce: Упрощенная обработка данных в больших кластерах. Коммун. АКМ 2008, 51, 107–113. [Перекрестная ссылка]
2. Проект Apache Hadoop: программное обеспечение с открытым исходным кодом для надежных, масштабируемых, распределенных вычислений. Доступно онлайн: https://hadoop.apache.org/ (по состоянию на 10 сентября 2021 г.).
3. Швачко, К.; Куанг, Х.; Радия, С.; Ченслер, Р. Распределенная файловая система Hadoop. В материалах 26-го симпозиума IEEE по системам и технологиям хранения данных (MSST) 2010 г., Инклайн-Виллидж, Невада, США, 3–7 мая 2010 г.; стр. 1–10.
4. Захария, М.; Чоудхури, М.; Франклин, MJ; Шенкер, С.; Стойка, И. Спарк: Кластерные вычисления с рабочими наборами. ХотКлауд 2010, 10, 95.
5. Оустерхаут, К.; Расти, Р.; Ратнасами, С.; Шенкер, С.; Чун, Б.Г. Осмысление производительности в средах анализа данных. В материалах 12-го симпозиума USENIX по проектированию и внедрению сетевых систем (NSDI), Окленд, Калифорния, США, 4–6 мая 2015 г.; стр. 293–307.
6. Син, В.; Горбани, А. Алгоритм взвешенного PageRank. В материалах второй ежегодной конференции IEEE по исследованию коммуникационных сетей и услуг, Фредериктон, Северная Каролина, Канада, 21 мая 2004 г.; стр. 305–314.
7. Чакрадхар, ST; Агравал, В.Д.; Ротвейлер, С.Г. Алгоритм транзитивного замыкания для генерации тестов. IEEE Транс. Компьютерный дес. Интегр. Сист. цепей. 1993, 12, 1015–1028. [Перекрестная ссылка]
8. О'Мэлли, О. Терабайтная сортировка в Apache Hadoop. Яху. Май 2008 г. стр. 1–3. Доступно онлайн: http://sortbenchmark.org/ YahooHadoop.pdf (по состоянию на 10 сентября 2021 г.).
9. Кластеризация K-средних. Доступно в Интернете: https://en.wikipedia.org/wiki/K-means_clustering (по состоянию на 10 сентября 2021 г.).
10. Захария, М.; Чоудхури, М.; Дас, Т.; Дэйв, А.; Ма, Дж.; МакКоли, М.; Франклин, MJ; Шенкер, С.; Стойка, И. Устойчивые распределенные наборы данных: отказоустойчивая абстракция для кластерных вычислений в памяти. В материалах 9-го симпозиума USENIX по проектированию и внедрению сетевых систем (NSDI), Сан-Хосе, Калифорния, США, 25–27 апреля 2012 г.; стр. 15–28.
11. Дэвидсон А.; Или A. Оптимизация производительности перемешивания в Spark; Технический отчет; Беркли, факультет электротехники и компьютерных наук, Калифорнийский университет: Беркли, Калифорния, США, 2013 г.
12. Николае Б.; Коста, ЦДХ; Мисале, К.; Катринис, К.; Парк, Ю. Использование адаптивного ввода-вывода для оптимизации шаблонов коллективного перетасовки данных для анализа больших данных. IEEE Транс. Параллельное распределение. Сист. 2017, 28, 1663–1674. [Перекрестная ссылка]
13. Чжан Х.; Чо, Б.; Сейфе, Э.; Чинг, А.; Фридман, М. Дж. Риффл: Оптимизированный сервис перемешивания для крупномасштабного анализа данных. В материалах тринадцатой конференции EuroSys; ЕвроСис '18; Ассоциация вычислительной техники: Нью-Йорк, штат Нью-Йорк, США, 2018 г. [CrossRef]
For more information:1950477648nn@gmail.com